Service
Voicebox
2026.04.27
·Web·by 네루#AI#Local Inference#Open Source#TTS#Voice Cloning
핵심 포인트
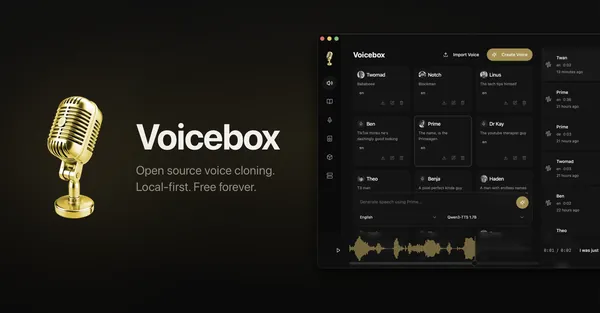
- 1Voicebox는 ElevenLabs와 WisprFlow의 무료 로컬 대안으로, voice cloning, speech generation, dictation 및 AI agent와의 음성 상호작용 기능을 사용자 머신에서 제공하는 오픈 소스 AI 음성 스튜디오입니다.
- 2이 소프트웨어는 몇 초의 오디오로 voice cloning을 지원하고, Whisper 기반의 transcription, Qwen3 LLM을 통한 transcript refinement, 그리고 Metal, CUDA 등을 활용한 로컬 GPU inference를 통해 고품질 음성 생성을 가능하게 합니다.
- 3Voicebox는 다양한 TTS engines, multi-voice content 생성을 위한 Stories Editor, 오디오 효과 파이프라인, 그리고 어떠한 앱에서도 활용 가능한 내장 REST API를 제공하여 개발자와 크리에이터에게 강력하고 유연한 도구입니다.
Voicebox는 음성 복제, 음성 생성, 받아쓰기 및 AI 에이전트와의 대화를 위한 오픈 소스 AI 음성 스튜디오로, 모든 기능이 사용자 기기에서 로컬로 실행됩니다.
핵심 기능 및 방법론:
- 음성 복제 (Voice Cloning):
- 최소 3초의 오디오 샘플을 통해 자연스러운 억양과 감정을 가진 거의 완벽한 음성 복제를 제공합니다.
- 샘플 입력 방식은 오디오 파일 업로드(WAV, MP3, FLAC, WebM), 마이크 직접 녹음(최대 30초), 또는 시스템 오디오 캡처(YouTube, 팟캐스트 등)를 지원합니다.
- 복제된 음성은 여러 Text-to-Speech (TTS) 엔진을 통해 고품질의 음성 생성을 가능하게 합니다.
- 음성 생성 (Speech Generation):
- 최대 50,000자까지 한 번에 생성할 수 있으며, 텍스트는 문장 경계에서 자동으로 분할되고 청크(chunk) 단위로 생성된 후 매끄럽게 교차 페이드(crossfaded)됩니다.
- 다양한 TTS 엔진을 지원하여 최적의 음성 품질과 제어 옵션을 제공합니다:
- Qwen3-TTS (Alibaba, 1.7B/0.6B): 고품질 다국어 복제 및 자연스러운 운율을 제공하며, 자연어 명령을 통해 음조, 속도, 감정 등의 Delivery instructions를 제어할 수 있는 유일한 엔진입니다.
- Chatterbox (Resemble AI): 23개 언어를 지원하며, 제로샷 복제 및 감정 과장 제어가 가능한 프로덕션 등급의 복제 기능을 제공합니다.
- Chatterbox Turbo (Resemble AI, 350M): 경량화되고 빠르며,
[laugh],[sigh],[gasp]와 같은 Paralinguistic tags를 텍스트에 직접 포함할 수 있습니다. - LuxTTS (ZipVoice): CPU 친화적이며 48kHz로 초고속(CPU에서 150배 실시간 이상, 약 1GB VRAM 필요) 복제를 지원하여 빠른 반복 작업에 적합합니다.
- Qwen CustomVoice (Alibaba, 1.7B/0.6B): 9개의 프리미엄 사전 설정된 스피커를 제공하며, "Speak slowly with warmth"와 같은 자연어 스타일 제어가 가능합니다.
- TADA (Hume AI, 3B/1B): 텍스트-음향 이중 정렬(text-acoustic dual alignment)을 가진 Speech-language model로, 700초 이상의 일관된 장문 오디오 생성에 최적화되어 있습니다.
- Kokoro (hexgrad, 82M): 82M 파라미터의 경량 TTS 모델로, CPU 실시간으로 작동하며 무시할 만한 VRAM을 사용합니다. 사전 구축된 음성 스타일(Pre-built voice styles)을 통해 음성 선택 후 즉시 생성이 가능합니다.
- 받아쓰기 (Dictation) 및 전사 (Transcription):
⌘ ⌥(macOS) 또는Ctrl Alt(Windows) 단축키를 사용하여 어떤 앱에서도 받아쓰기가 가능하며, 전사된 텍스트는 해당 앱의 텍스트 필드나 클립보드에 입력됩니다.- Whisper (OpenAI, 1.5B/769M/244M/74M): 99개 언어를 지원하는 다국어 음성 인식(ASR) 모델을 통해 정확한 Speech-to-Text 기능을 제공합니다. 사용자의 하드웨어와 품질 요구사항에 따라 Tiny부터 Large까지 다양한 크기를 선택할 수 있습니다.
- Whisper Turbo (OpenAI, 809M): Whisper Large v3의 Pruned 버전으로, 거의 동일한 품질을 유지하면서 약 8배 빠른 속도를 제공하여 실시간 받아쓰기에 적합합니다.
- 전사된 텍스트는 로컬 Large Language Model (LLM)인 Qwen3 (Alibaba, 4B/1.7B/0.6B)을 사용하여 "um"이나 자기 수정, 구두점 등을 제거하는 Refined transcripts 기능을 제공합니다. 이 과정은 사용자 기기 내에서만 이루어지며, 재구문화를 하지 않습니다.
- 에이전트 연동 (Agent Integration):
- MCP (Message Control Protocol)를 지원하는 에이전트(예: Claude Code, Cursor, Cline)는
voicebox.speak도구 호출을 통해 Voicebox에서 복제된 음성으로 사용자에게 말할 수 있습니다. - 각 MCP 클라이언트에 특정 음성 프로필을 바인딩하여, 어떤 에이전트가 말하는지 음성으로 식별할 수 있습니다.
- 에이전트가 시작한 모든 음성 출력은 화면에 필(pill) 형태로 표시되어 사용자가 항상 시스템의 음성 출력을 인지할 수 있도록 합니다.
- MCP (Message Control Protocol)를 지원하는 에이전트(예: Claude Code, Cursor, Cline)는
- Stories Editor 및 오디오 효과 (Audio Effects Pipeline):
- Stories Editor를 통해 타임라인 기반으로 다중 음성 내러티브를 생성하고, 트랙 정렬, 클립 트리밍, 캐릭터 간의 대화 믹싱이 가능합니다.
- 피치 시프트, 리버브, 딜레이, 압축 등 다양한 오디오 효과를 적용하고 프리셋으로 저장할 수 있으며, 효과를 실시간으로 미리 보고 음성 프로필별 기본값으로 설정할 수 있습니다.
- 로컬 및 원격 추론 (Local or Remote Inference):
- Metal, CUDA, ROCm, Intel Arc, DirectML과 같은 GPU를 사용하여 로컬에서 추론을 실행하거나, 원격 머신에 연결할 수 있습니다.
- 개성 (Personalities) 기능:
- 음성 프로필에 자유 형식의 개성을 부여하여, 해당 개성에 맞춰 텍스트를 재작성(Rewrite)하거나, 캐릭터가 새로운 대사를 즉석에서 생성(Compose)하도록 할 수 있습니다.
- 내장 REST API:
- 다운로드된 모든 엔진은 사용자 기기에서 REST API 엔드포인트가 되어, API 키, 속도 제한, 문자당 비용 없이 프로그램적으로 Voicebox를 제어할 수 있습니다. 이는 게임, 앱, 스크립트 및 도구 개발에 활용될 수 있습니다.
Voicebox는 macOS, Windows, Linux를 지원하며, 별도의 종속성 없이 로컬에서 완벽하게 작동합니다.