MiniMax M3: Frontier Coding, 1M Context, Native Multimodality — All in One Model - MiniMax Research
핵심 포인트
- 1MiniMax M3는 코딩 및 에이전트 작업에서 최첨단 성능을 제공하며, MSA(MiniMax Sparse Attention) 아키텍처를 통해 최대 1M 토큰의 초장문맥을 지원하고 네이티브 멀티모달 기능을 통합한 최초의 오픈 웨이트 모델입니다.
- 2M3는 SWE-Bench Pro 및 SVG-Bench와 같은 벤치마크에서 기존 모델들을 능가하는 성능을 보였으며, 특히 MSA는 1M 컨텍스트에서 이전 세대 모델 대비 토큰당 연산량을 1/20로 줄이고 디코딩 속도를 15배 향상시키는 등 효율성에서 혁신을 이루었습니다.
- 3실제 사용 사례에서 M3는 독립적인 논문 재현, CUDA 커널 최적화, 그리고 자율적인 모델 훈련과 같은 복잡한 장기 작업을 성공적으로 수행하며, 이는 MiniMax Code 제품 및 API 서비스를 통해 개발자들에게 제공됩니다.
MiniMax M3는 코딩 및 에이전트 작업과 같은 전문화된 태스크에서 frontier-level 성능을 달성하는 모델로 공식 출시되었습니다. M3는 MiniMax Sparse Attention (MSA)이라는 새로운 attention architecture를 사용하며, 최대 1M 토큰의 ultra-long context window를 지원합니다. 또한, natively multimodal 모델로서 이미지 및 비디오 입력을 지원하고 데스크톱 컴퓨터를 조작할 수 있습니다. MiniMax M3는 이 세 가지 핵심 역량을 모두 갖춘 최초이자 유일한 open-weight 모델입니다.
MSA: Architectural Innovation Enables Context Scaling
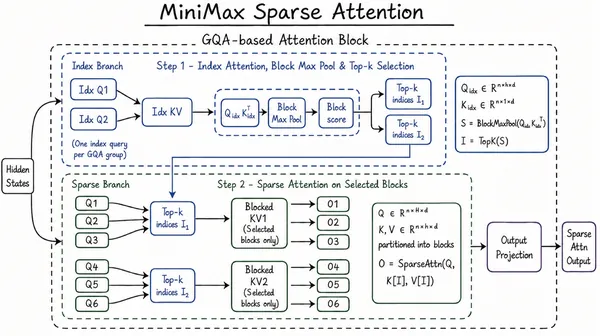
MSA는 full attention의 quadratic computational complexity 성장이라는 "inherent flaw"를 해결하기 위해 개발되었습니다. 이는 clean하고 쉽게 확장 가능한 새로운 sparse attention architecture입니다. MSA는 M3에 1M context window를 제공하며, context를 스케일링 가능한 또 다른 차원으로 만듭니다. 일반적인 sparse attention 메커니즘은 pre-filtering 단계를 추가하여 복잡성 폭발 문제를 피합니다. MSA는 DSA 및 MoBA와 같은 접근 방식과 비교하여 KV를 더 정밀하게 블록으로 분할하여 더 높은 effective context coverage를 달성합니다. 동시에, operator level에서 직접 최적화하여 "KV outer gather Q" 접근 방식을 채택했습니다. 이는 KV 블록을 outer loop로 사용하여 해당 블록에 도달하는 query를 통합합니다. 각 블록은 한 번만 읽히고 memory access가 contiguous합니다. M3의 head configuration에서 arithmetic intensity는 일반적인 방법보다 훨씬 우수하며, open-source Flash-Sparse-Attention 및 flash-moba보다 4배 이상 빠릅니다. MSA의 clean하고 scalable하며 hardware-friendly한 특성 덕분에 이론적 이점을 실제에서 완전히 실현할 수 있습니다. 1M의 context length에서 M3의 per-token compute는 이전 세대 모델의 1/20에 불과하며, prefilling stage에서 9배 이상, decoding stage에서 15배 이상 속도 향상을 이루었습니다. 또한, MSA는 대부분의 기능에서 full attention과 일치하는 성능을 보였습니다.
Frontier Coding and Agentic Capabilities
M3는 코딩 및 에이전트 역량을 핵심 개선 영역으로 삼았습니다. SWE-Bench Pro (59.0%), Terminal-Bench 2.1 (66.0%), SWE-fficiency (34.8%), KernelBench Hard (28.8%), MCP Atlas (74.2%) 등 국제적으로 인정받는 벤치마크에서 선도적인 성능을 보여줍니다. 기존 코딩 벤치마크가 실제 사용자 경험을 충분히 반영하지 못하는 점을 개선하기 위해, MiniMax 팀은 interactive user simulator framework를 구축했습니다. 이 프레임워크는 실제 개발자의 협업 행동 패턴(요구 사항 설명, 솔루션 논의, 피드백 기반 수정, 연속적인 작업 전환, 복잡한 프로젝트 반복)을 시뮬레이션하여 모델이 실제 프로덕션 환경에 더 가까운 interaction scenario에 노출되도록 훈련 및 평가합니다. 이를 통해 에이전트는 단순히 지시를 수동적으로 실행하는 것을 넘어, 사용자와 적극적으로 협력하여 작업을 완료할 수 있습니다. M3는 코딩 및 에이전트에게 중요한 데이터를 스케일링하여 벤치마크 리더십뿐만 아니라 실제 R&D 워크플로우에서 신뢰할 수 있는 협업 파트너가 되는 것을 목표로 합니다.
Multimodality: Interleaved Training, Continued Scaling
M3는 Step 0부터 mixed-modality training을 거친 모델입니다. 이 native multimodal 접근 방식은 다른 modality의 semantic space를 더 자연스럽고 깊이 있게 병합할 수 있도록 합니다. 데이터 혼합 및 구성 측면에서, 팀의 광범위한 실험 결과 interleaved data가 모델 성능 향상에 일반적으로 가정하는 것보다 훨씬 중요하다는 것을 보여주었습니다. 텍스트와 이미지 또는 다른 modality가 시퀀스 내에서 자연스럽게 섞이는 이러한 데이터는 전체 훈련 데이터 스케일링에도 중요합니다. 이 데이터를 위해 전체 데이터 파이프라인을 재구축하여 훈련 데이터를 토큰(100 trillion tokens) 규모로 확장할 수 있게 되었습니다.
Real-World Tasks
M3의 실제 사용 및 테스트에서 다음과 같은 인상적인 결과가 있었습니다.
- Independent Paper Reproduction: ICLR 2025 우수 논문 "Learning Dynamics of LLM Finetuning"을 M3에게 독립적으로 재현하도록 요청했습니다. M3는 약 12시간 동안 자율적으로 실행되어 18개의 commit과 23개의 실험 그림을 생성하고 핵심 실험을 성공적으로 완료했습니다. 이는 prediction-probability 변화의 추세를 일치시키고 DPO 실험에서 강조된 squeezing effect를 관찰하며 원본 논문의 Extend mitigation method를 검증했습니다. 이 과정에서 multimodal 능력(곡선, 데이터, 수식 이해), long context(논문, 코드, 실험 로그), 강력한 코딩 및 에이전트 능력이 모두 요구되었습니다.
- CUDA Kernel Optimization: NVIDIA Hopper architecture GPU에서 FP8 matrix multiplication (GEMM) kernel을 최적화하는 데 M3를 사용했습니다. M3는 초기 task description, benchmark evaluation script, 그리고 실행 불가능한 Triton skeleton만 가지고 시작했으며, 참조할 고성능 구현은 없었습니다. 약 24시간 동안 연속 실행하여 147개의 벤치마크 제출과 1,959개의 tool call을 수행했습니다. baseline 구현부터 production-grade optimization(autotune configuration generation, performance bottleneck diagnosis, CUDA Graph integration, persistent kernel rewriting, host-side scheduling optimization)까지 전 과정을 자율적으로 진행했으며, 각 단계는 벤치마크 피드백을 통해 자체 검증되었습니다. M3는 초기 버전의 Hopper FP8 hardware peak utilization 7.6%를 71.3%로 개선하여 9.4배의 속도 향상을 달성했습니다. M3는 여러 성능 정체기를 겪었음에도 불구하고 계속해서 다른 최적화 방향을 탐색했으며, 최적의 솔루션은 145번째 제출에서 나타났습니다.
- Letting M3 Train Models (PostTrainBench): M3는 PostTrainBench에서 자율적 의사결정이 필요한 시나리오에서 테스트되었습니다. M3에게 사전 훈련만 완료된 4개의 Base model을 제공하고 12시간 내에 데이터 합성, 훈련, 평가, 반복의 전체 과정을 자율적으로 완료하도록 했습니다. 목표는 이 모델들이 수학적 추론(AIME2025), tool calling (BFCL), 과학적 지식 추론(GPQA Main), 기본 산술 추론(GSM8K), 코드 생성(HumanEval)에서 기본적인 능력을 습득하게 하는 것이었습니다. M3는 최종적으로 0.37점을 기록하여 Opus 4.7(0.42) 및 GPT-5.5(0.39)보다는 약간 낮았지만 다른 모델들보다는 명확히 앞섰습니다.
MiniMax Code
M3 출시와 함께 MiniMax Code도 업데이트되었습니다. MiniMax Code는 M3를 위해 특별히 설계되고 M3와 함께 훈련된 에이전트 제품으로, M3의 long context, 코딩/에이전트 작업, native multimodality 역량을 최대한 활용합니다. 복잡한 장기 태스크를 위해 MiniMax Code의 Agent Team은 큰 태스크를 여러 단계의 병렬적이고 동적으로 조정 가능한 워크플로우로 분해하고, 이를 에이전트 클러스터가 협력하여 진행합니다. Producer + Verifier adversarial harness loop를 통해 Agent Team은 실행 중에 지속적으로 생성, 반영, 자체 수정할 수 있습니다. 또한 MiniMax Code는 M3의 native multimodal 역량 덕분에 컴퓨터 사용(desktop operation)을 지원합니다.
MiniMax Token Plan 및 API 서비스
MiniMax Token Plan은 M3 모델을 더 많은 사용자에게 제공하기 위해 Plus (50/월, ~5.1B 토큰), Ultra ($120/월, ~9.8B 토큰) 세 가지 tier로 업데이트되었습니다. 텍스트, 이미지, 음성, 음악은 동일한 사용 풀을 공유합니다. M3 API도 출시되었으며, 512K 토큰 이하의 입력에 대해서는 표준 요금이 부과되고, 512K 토큰 초과 시에는 더 높은 long-context 요금이 적용됩니다. M3는 thinking 모드를 켜거나 끌 수 있어 복잡한 추론 및 에이전트 작업과 낮은 지연 시간 요구 사항에 모두 적합합니다.