Blog
LLM은 어떻게 이미지를 이해할까?
2026.07.04
·Web·by Leon#BLIP-2#Image Captioning#LLM#Multimodal AI#Vision Transformer
핵심 포인트
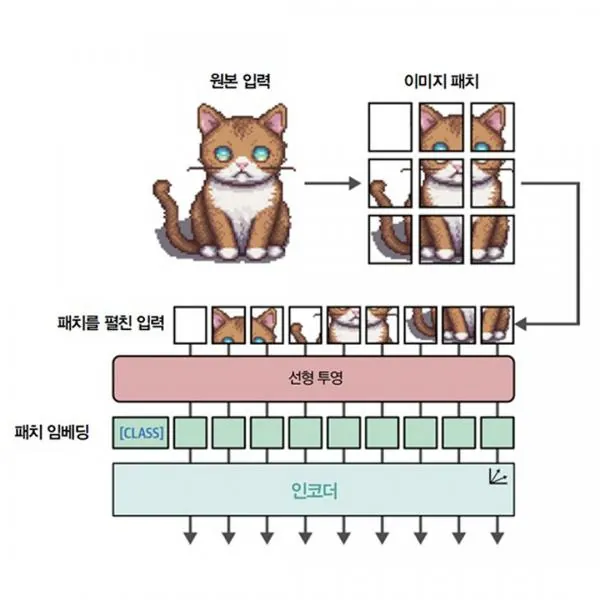
- 1비전 트랜스포머(ViT)는 이미지를 텍스트의 토큰과 유사한 형태인 패치(patch) 단위로 분할하여, 트랜스포머 아키텍처가 시각 데이터를 효과적으로 학습하고 처리할 수 있게 합니다.
- 2BLIP-2는 사전 훈련된 비전 인코더와 대규모 언어 모델(LLM) 사이에 훈련 가능한 Q-포머(Querying Transformer)를 배치하여, 멀티모달 모델을 처음부터 구축하는 대신 효율적으로 간극을 메웁니다.
- 3Q-포머는 이미지 정보를 LLM이 이해할 수 있는 소프트 시각 프롬프트(soft visual prompt)로 변환하여 전달함으로써, 멀티모달 LLM이 이미지 캡션 생성과 같은 복합적인 작업을 수행하도록 돕습니다.
이 논문은 텍스트 중심의 LLM이 이미지 데이터를 이해하고 처리하는 멀티모달 LLM으로 진화하는 과정과 그 핵심 기술인 Vision Transformer(ViT) 및 BLIP-2의 아키텍처를 심층적으로 설명합니다.
1. Vision Transformer (ViT): 이미지의 토큰화
ViT는 컴퓨터 비전 분야에 트랜스포머 구조를 도입하여 기존 CNN의 한계를 극복했습니다. 핵심은 이미지를 텍스트 데이터와 같이 처리 가능한 ‘토큰’으로 변환하는 과정에 있습니다.- 패치 분할 (Patching): 입력 이미지를 16×16 크기의 작은 패치(patch)로 분할합니다. 이는 텍스트 모델에서 문장을 단어로 토큰화하는 과정과 동일한 논리입니다.
- 선형 임베딩 (Linear Embedding): 각 이미지 패치는 고유 ID를 부여받는 대신, 선형 투영(linear projection)을 통해 트랜스포머가 처리할 수 있는 수치적 표현인 임베딩(embedding)으로 변환됩니다.
- 인코더 처리: 이렇게 생성된 패치 임베딩은 트랜스포머의 인코더로 전달됩니다. 이 시점부터 시각 데이터는 텍스트 토큰과 동일한 방식으로 처리되어, 복잡한 비정형 이미지 데이터가 분류 작업 등에 활용 가능한 표현으로 변환됩니다.
2. BLIP-2: 비전과 언어 모델 간의 간극 메우기
방대한 컴퓨팅 자원을 요구하는 멀티모달 모델을 밑바닥부터 학습시키는 대신, BLIP-2는 사전 훈련된 모델들을 효율적으로 연결하는 Q-Former(Querying Transformer)를 도입했습니다.- Q-Former 아키텍처: 동결된(frozen) ViT와 사전 훈련된 LLM 사이에 위치하여 두 모달리티 간의 가교 역할을 합니다. 이는 어텐션 층을 공유하는 '이미지 트랜스포머'와 '텍스트 트랜스포머'로 구성됩니다.
- 훈련 단계:
- 단계 1 (표현 학습): 이미지-텍스트 쌍(image-text pairs)을 사용하여 세 가지 작업(Image-Text Contrastive Learning, Image-Text Matching, Image-grounded Text Generation)을 수행합니다. 이를 통해 비전 임베딩에 텍스트 정보가 투영됩니다.
- 단계 2 (LLM 주입): Q-Former에서 추출된 학습 가능한 임베딩을 선형 투영 층(linear projection layer)을 거쳐 LLM에 전달합니다. 이때 임베딩은 LLM의 입력을 제어하는 소프트 시각 프롬프트(soft visual prompt) 역할을 수행합니다.
3. 멀티모달 LLM의 활용 및 의의
BLIP-2와 같은 아키텍처는 모델의 파라미터를 새로 학습하지 않고도 기존 LLM의 추론 능력을 시각 도메인으로 확장할 수 있게 합니다.- 이미지 캡셔닝: 전처리기를 통해 이미지를 픽셀 값으로 변환하고, 이를 소프트 시각 프롬프트로 변환하여 LLM에 입력함으로써 이미지에 대한 묘사를 생성합니다.
- 기술적 확장: 이러한 구조는 LLaVA, Idefics 2와 같은 현대적 시각 LLM 모델의 근간이 되며, 사전 훈련된 인코더의 비전 특성을 언어 임베딩 공간에 투영하여 멀티모달 이해도를 극대화합니다.
결론적으로, 본 논문은 이미지를 패치 단위의 임베딩으로 변환하고, Q-Former를 통해 시각 정보와 언어 정보의 정렬(alignment)을 최적화하는 것이 멀티모달 시스템 구현의 핵심임을 강조합니다.