Blog
KV 캐시는 어디까지 내려갈 수 있을까요?
Sigrid Jin (Jin Hyung Park) 🌈
2026.07.17
·LinkedIn·by Mineru#HiCache#KV Cache#LLM#Prefix Caching#SGLang
핵심 포인트
- 1LLM의 긴 컨텍스트 처리를 최적화하기 위해 도입된 **Prefix Caching**은 **KV Cache**를 재사용하여 중복된 프리필 연산을 효과적으로 줄여줍니다.
- 2**RadixAttention**에서 발전한 **HiCache**는 GPU, CPU, 스토리지 간의 계층적 메모리 구조와 **page-first** 레이아웃을 통해 캐시 히트율과 처리량을 획기적으로 개선했습니다.
- 3최근 **Sliding Window Attention** 및 다양한 컨볼루션 상태가 혼합된 복합 모델들은 **Radix Tree** 구조를 넘어 **flat paged pool**과 같은 이질적 상태 관리에 최적화된 새로운 메모리 할당 전략으로 진화하고 있습니다.
본 논문은 LLM 서빙 환경에서 고질적인 병목인 KV 캐시의 비효율을 해결하기 위한 프리픽스 캐싱(Prefix Caching)의 진화 과정과, 복잡해지는 모델 아키텍처에 대응하기 위한 최신 메모리 관리 기법들을 심도 있게 다룬다.
1. KV 캐시와 프리픽스 캐싱의 기초
LLM 추론은 프리필(Prefill)과 디코드(Decode) 단계로 나뉜다. 프리필 단계는 입력 프롬프트의 KV 벡터를 생성하여 저장소인 KV 캐시에 쌓는 과정으로 연산 병목이 발생하며, 디코드 단계는 저장된 KV를 반복 참조하므로 메모리 대역폭이 병목이 된다. 프리픽스 캐싱은 멀티턴 대화나 에이전트 서비스에서 중복되는 입력 구간을 재사용하여 프리필 연산을 생략하는 기법이다.2. RadixAttention과 HiCache의 계층 구조
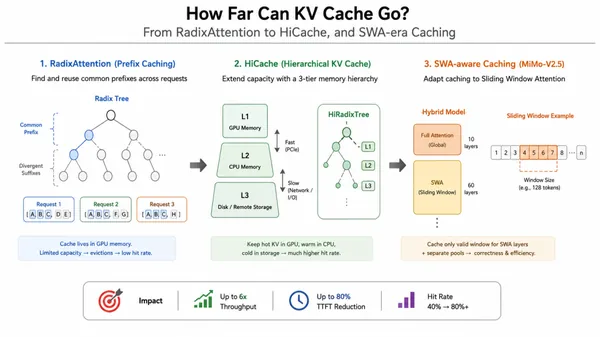
- RadixAttention: SGLang이 제안한 방식으로, radix tree를 사용하여 요청들의 공통 프리픽스를 정밀하게 매칭하고 캐시를 관리한다.
- HiCache: GPU 메모리(L1)의 용량 한계를 극복하기 위해 CPU 메모리(L2)와 원격 스토리지(L3)까지 계층을 확장했다.
- 데이터 플레인: 기존 layer-first 레이아웃을 page-first로 재배치하여 I/O 효율을 높였다. GPU 스레드를 직접 활용한 비동기 복사(DMA 대안)와 zero-copy 전송을 통해 PCIe 대역폭을 최적화했다.
- 컨트롤 플레인: CPU-GPU 구간은 레이어별 연산과 전송을 오버랩(Overlap)하는 파이프라이닝을 적용하고, 스토리지-CPU 구간은 요청 대기 시간을 프리페치(Prefetch)에 활용하는 전략을 취한다.
3. SWA(Sliding Window Attention) 대응 캐싱
모델 아키텍처가 SWA 구조로 변하며 기존의 프리픽스 캐싱 전제가 무너졌다. 윈도우 밖 KV가 수시로 삭제되기 때문이다.- MiMo 팀의 접근: Full Attention과 SWA 풀을 물리적으로 분리하고,
window-safe length라는 규칙을 적용해 윈도우 범위만큼의 KV가 보존된 경우에만 캐시 히트를 인정한다. 이를 통해 무효한 메모리 참조를 방지하고 실효 히트율을 극대화했다.
4. Flat Paged Pool과 Heterogeneous View로의 패러다임 전환
최신 MoE 모델(예: Inkling)은 Full Attention, SWA, Convolutional state 등 성격이 다른 영속 상태를 동시에 유지해야 한다.- TokenSpeed의 재설계: 기존의 트리 방식이 이질적인 상태 관리에 한계를 보이자, 물리적 할당 단위는 하나로 통일하고 논리적 해석(View)을 상태 종류마다 다르게 적용하는 'Flat paged pool' 구조로 전환했다.
- 블록 ID당 고정된 물리 슬롯을 할당하되, 상태 종류(Full Attention, SWA 등)에 따라 해당 슬롯 내 토큰 밀도를 다르게 해석하여 메모리 패딩 낭비를 방지한다.
- 이는 vLLM의 Jenga 논문이나 LMDeploy의 TurboMind와 맥락을 같이하며, 물리 할당과 논리적 정책을 분리함으로써 확장성과 효율성을 동시에 달성했다.